Nombre de Bacon
On part d’un ensemble de 250 films populaires. Pour chaque film, on a la liste des acteurs qui y jouent.
À partir de ces informations, on peut créer un graphe où les sommets sont les films et les acteurs et où une arête lie un acteur à un film dans lequel il joue.
Le graphe obtenu est biparti car il n’y a pas d’arête entre les acteurs, ni entre les films, seulement entre sommets de catégories différentes.
Ce graphe va nous permettre de tester l’effet « petits mondes » qui consiste à obtenir des distances faibles entre deux sommets quelconques lorsque les graphes sont suffisamment interconnectés. Le graphe est alors gros mais peu large (petit diamètre) !
Le « nombre de Bacon » d’un acteur est le chiffre caractérisé par le degré de séparation qu’il a avec Kevin Bacon. C’est une application du nombre d’Erdős au secteur du cinéma. Plus le chiffre est grand, plus l’acteur en question est éloigné de Bacon.
- Le nombre de Bacon de Kevin Bacon lui-même est 0
- Le nombre de Bacon d’un acteur A ayant tourné directement avec Kevin Bacon est 1
- Si le plus nombre de Bacon d’un acteur avec qui A a tourné est N, le Bacon number de A est N + 1.
Première mission :
Créer une fonction qui donne le nombre de Bacon d’un acteur A et qui affiche la chaîne “acteur A - film A - acteur B - film B - … - Kevin Bacon” sur notre jeu de données restreint.
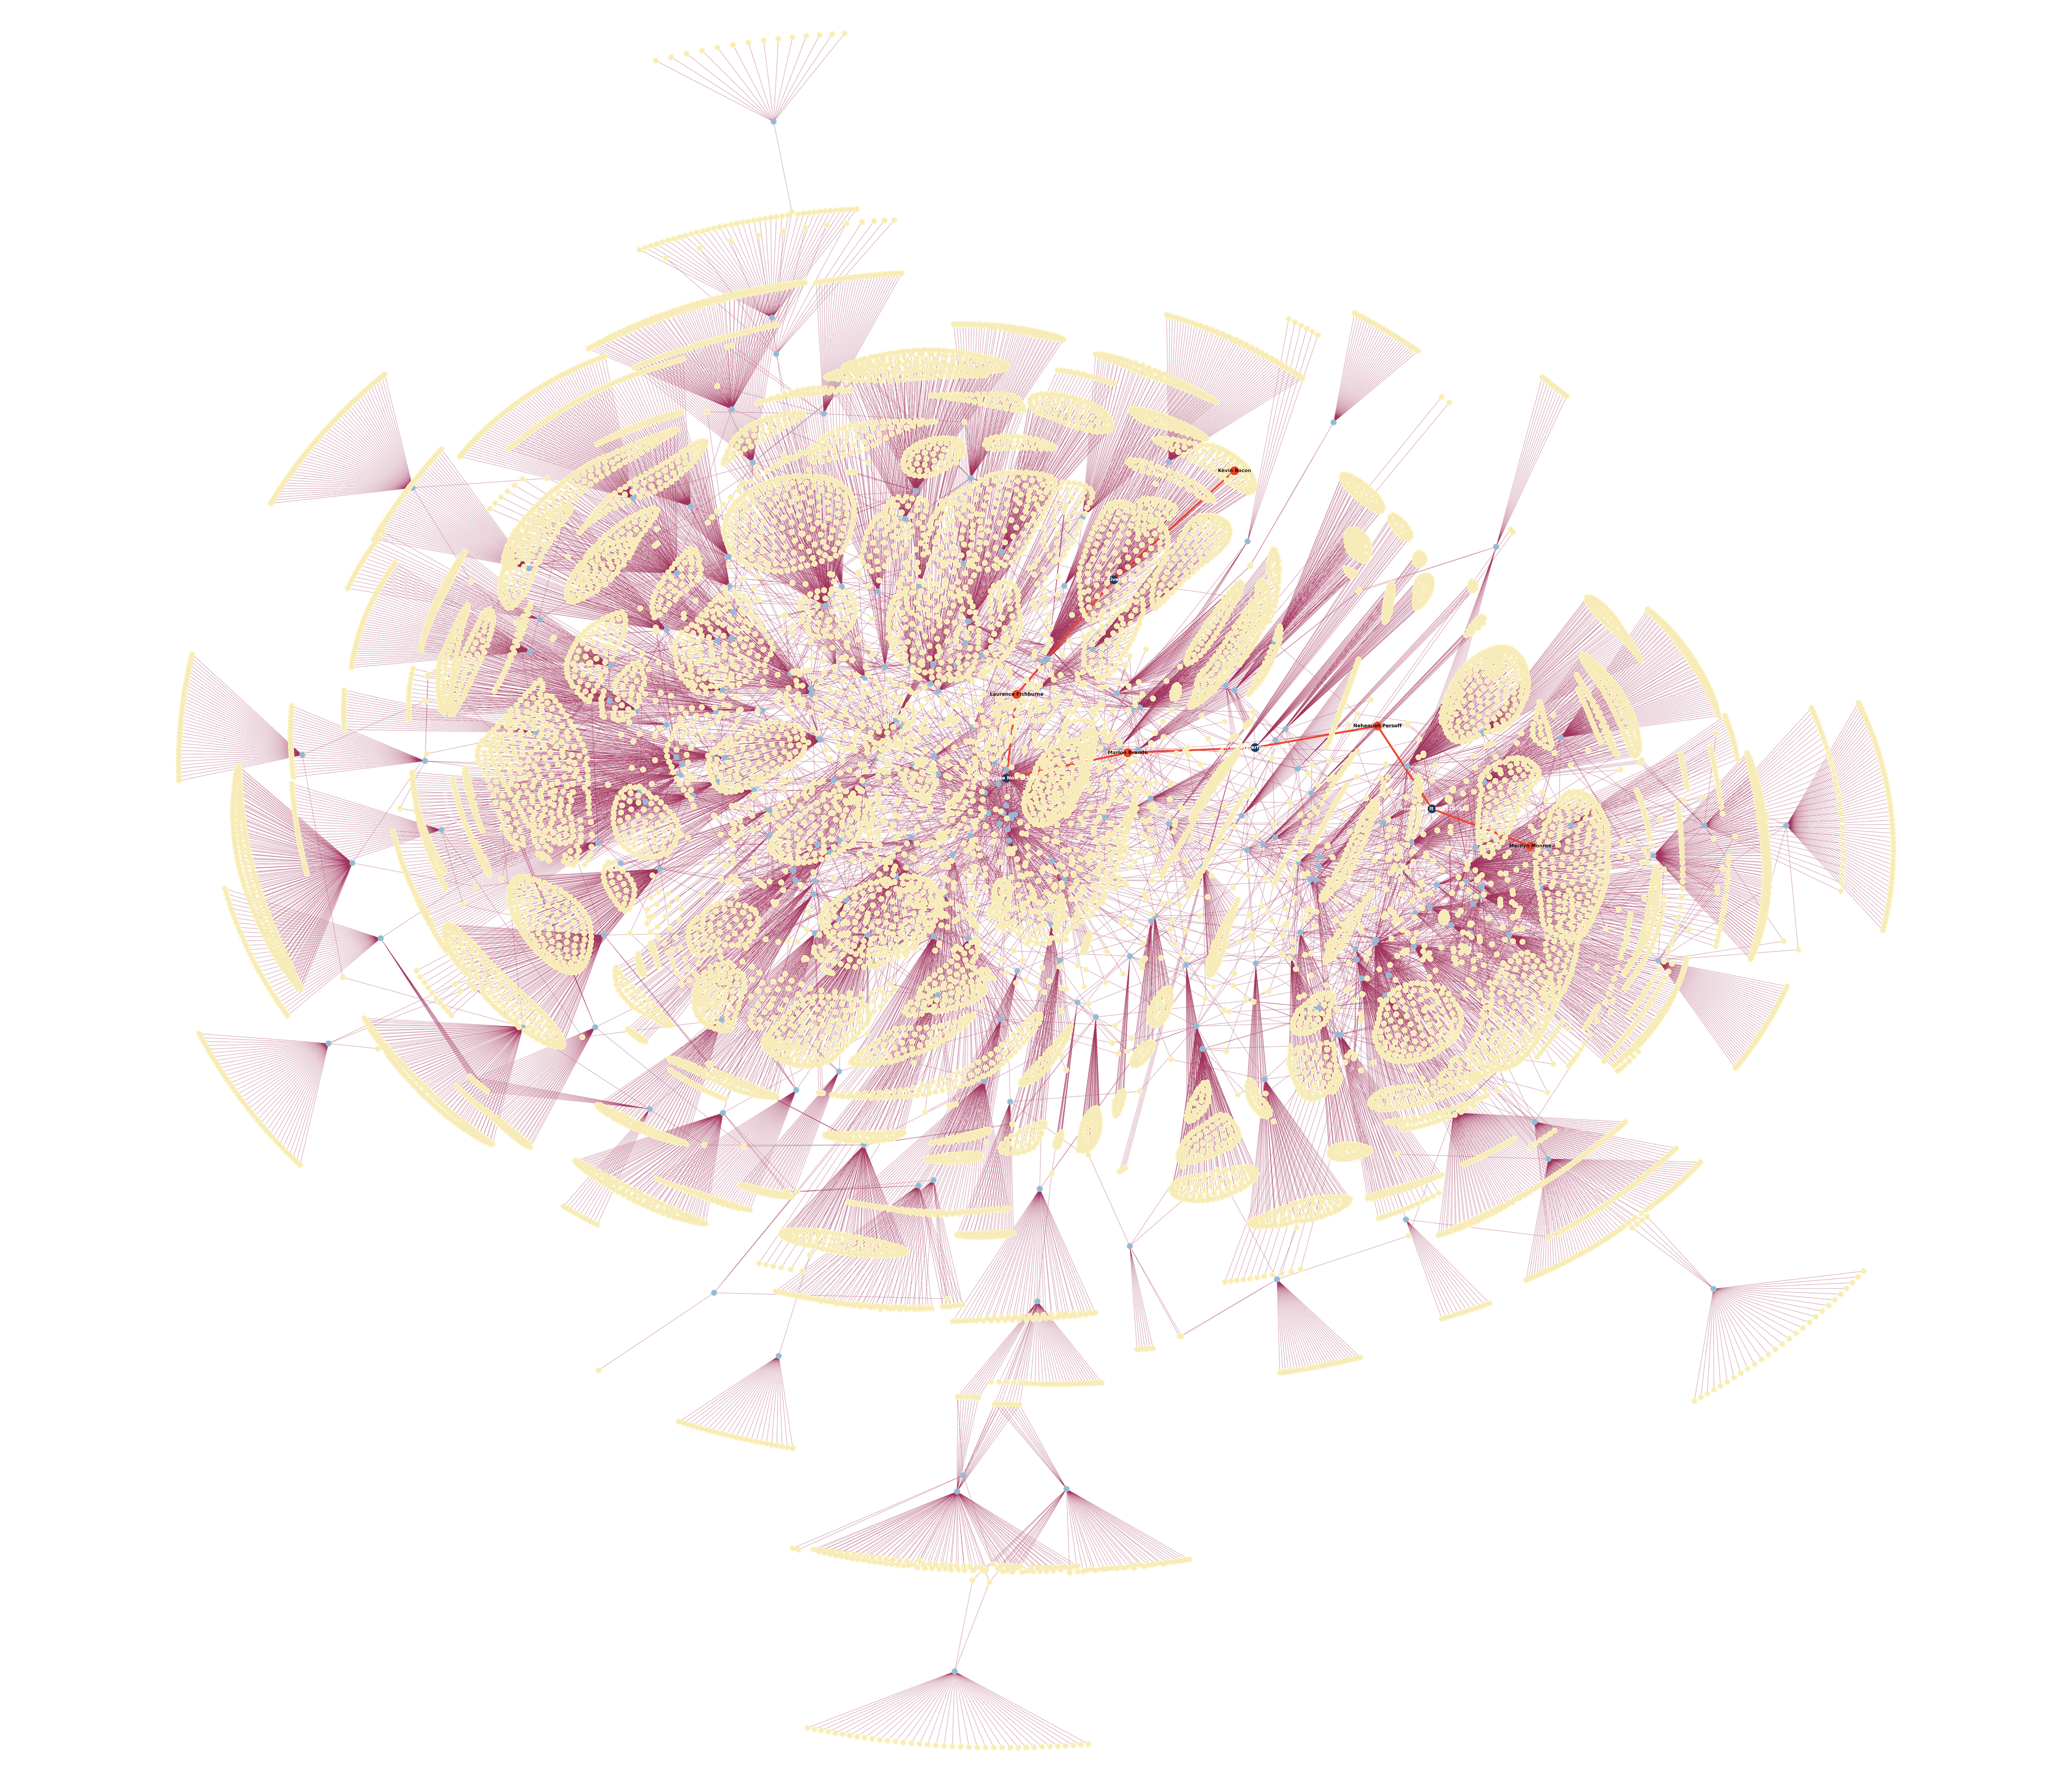
Pour cela, il faudra d’abord créer la matrice d’adjacence du graphe ayant pour sommets tous les films et acteurs et dont les arêtes lient un acteur au film dans lequel il joue.
Puis l’idée est d’utiliser un parcours en largeur avec une reconstruction de chemin.
Lignes de code pour récupérer les données du fichier dans une liste data (chaque élément de data est une ligne du fichier texte) :
import requests
response = requests.get("http://cs.oberlin.edu/~gr151/imdb/imdb.top250.txt")
data = response.text.split('\n')
Seconde mission :
Toujours grâce à un parcours en largeur, vous recenserez les différents domaines connexes du graphe.
Ensuite, vous calculerez la distance moyenne d’un acteur avec les autres acteurs de son domaine, dans le plus gros des domaines.
Une solution pour la première mission :
Récupération des données :
import requests
response = requests.get("http://cs.oberlin.edu/~gr151/imdb/imdb.top250.txt")
data = response.text.split('\n')
Fabrication du graphe et de la liste des acteurs :
LA = {}
Acteurs = {}
Films = {}
for ligne in data[:-1]:
    acteur,film = ligne.split('|')
    if acteur[-3:] == '(I)':
        acteur = acteur[:-4]
    if acteur not in Acteurs: # utiliser un dictionnaire permet de ne pas passer en O(n^2)
        Acteurs[acteur] = True
    if film not in Films: # idem
        Films[film] = True
    if acteur not in LA:
        LA[acteur] = [film]
    else:
        LA[acteur] += [film]
    if film not in LA:
        LA[film] = [acteur]
    else:
        LA[film] += [acteur]
print(f"{len(Films)} films où jouent {len(Acteurs)} acteurs.")
250 films où jouent 12465 acteurs.
Parcours en largeur avec mémorisation des prédécesseurs pour reconstituer ensuite le chemin le plus court :
from collections import deque
def parcours_largeur(G,depart,cible):
    file = deque()
    file.append((depart,depart))
    Parents = {depart : None}
    Vus_sommet = {}
    while file:
        sommet,parent = file.popleft()
        if not sommet in Vus_sommet:
            for v in G[sommet]:
                file.append((v,sommet))
            Parents[sommet] = parent
            Vus_sommet[sommet] = True
            if sommet == cible:
                return Parents
    return None # depart et cible ne sont pas connectés
Reconstruction du chemin entre les deux acteurs :
def chemin(parents,cible,depart,chem):
    if cible == depart:
        return chem
    chem.append(parents[cible])
    return chemin(parents,parents[cible],depart,chem)

def rec_chem(parents,cible,depart):
    chem = [cible]
    chemin(parents,cible,depart,chem)
    return chem[::-1]
Et au final, le nombre de Bacon n’est autre que la moitié de la distance entre Francis Bacon et l’autre acteur (ce qui revient au nombre de films qui les séparent) :
depart = 'Kevin Bacon'
cible = 'Marilyn Monroe'
if cible not in Acteurs:
    print(f"Pas de {cible} dans la liste...")
else:
    parents = parcours_largeur(LA,depart,cible)
    ch = rec_chem(parents,cible,depart)
    for i in range(0,len(ch)-2,2):
      print(ch[i]+" - "+ch[i+1]+" - "+ch[i+2])
    print(f"distance : {(len(ch)-1)//2}")
Kevin Bacon - Mystic River (2003) - Laurence FishburneLaurence Fishburne - Apocalypse Now (1979) - Marlon BrandoMarlon Brando - On the Waterfront (1954) - Nehemiah PersoffNehemiah Persoff - Some Like It Hot (1959) - Marilyn Monroedistance : 4
Une solution pour la seconde mission :
Le code suivant permet de créer une liste de listes où chaque sous liste est un des domaines connexes.
def domaines_connexes(G):
    Domaines = []
    Vus_tous = {}
    for s in G:
        if s not in Vus_tous:
            file = deque()
            file.append(s)
            Vus = {}
            while file:
                sommet = file.popleft()
                if not sommet in Vus:
                    file += G[sommet]
                    Vus[sommet] = True
                    Vus_tous[sommet] = True
            Domaines.append(list(Vus.keys()))
    assert len(Vus_tous) == len(G) # check qu'on a bien vu tout le monde
    return Domaines
Vérification :
>>> DOM = domaines_connexes(LA)
>>> for i in range(len(DOM)):
...    print(f"Taille domaine {i} : {len(DOM[i])}")
Taille domaine 0 : 12035Taille domaine 1 : 108Taille domaine 2 : 32Taille domaine 3 : 33Taille domaine 4 : 86Taille domaine 5 : 31Taille domaine 6 : 150Taille domaine 7 : 47Taille domaine 8 : 22Taille domaine 9 : 49Taille domaine 10 : 13Taille domaine 11 : 51Taille domaine 12 : 38Taille domaine 13 : 7Taille domaine 14 : 13
Retirons ensuite du graphe et de la liste des acteurs, tous les sommets qui ne sont pas dans le domaine 0 :
LA0 = LA.copy()
Acteurs0 = Acteurs.copy()
Films0 = Films.copy()
for i in range(1,len(DOM)):
    for s in DOM[i]:
        del LA0[s]
        if s in Acteurs:
            del Acteurs0[s]
        if s in Films:
            del Films0[s]
print(f"Il y a {len(Films0)} films et {len(Acteurs0)} acteurs dans le plus gros domaine connexe.")
Il y a 233 films et 11802 acteurs dans le plus gros domaine connexe.
Comme on n’a plus besoin de reconstituer un chemin, écrivons une version simplifiée du parcours en largeur permettant de calculer la distance entre deux acteurs le plus vite possible.
def BFS0(G,depart,cible):
    file = deque()
    file.append((depart,0))
    Vus_sommet = {}
    while file:
        sommet,dist = file.popleft()
        for v in G[sommet]:
            if v == cible:
                return (dist+1)//2
            if not v in Vus_sommet:
                Vus_sommet[v] = True
                file.append((v,dist+1))
Une fonction permettant de trouver la distance moyenne d’un acteur aux autres :
def distMoy(acteur,G,listeActeurs):
    """
    précondition : G est connexe, acteur et listeActeurs appartiennent à G
    """
    listact = list(Acteurs0.keys())
    listact.remove(acteur)
    distMoy = 0
    nbPaires = 0
    for cible in listact:
        dist = BFS0(G,acteur,cible)
        distMoy += dist
        nbPaires += 1
    distMoy = distMoy/nbPaires
    return distMoy
Y a plus qu’à :
Acteur = "Tom Cruise"
if Acteur not in Acteurs0:
    print(f"{Acteur} n'est pas présent dans la liste")
else:
    print(f"La distance entre {Acteur} et un autre acteur du domaine 0 est en moyenne de {distMoy(Acteur,LA0,Acteurs0):.2f}.")
La distance entre Tom Cruise et un autre acteur du domaine 0 est en moyenne de 3.32.